O sistema de vendas caiu numa quinta à tarde, véspera de fechamento. O suporte prometeu resolver, ninguém soube dizer quando, e o dono só descobriu o tamanho do estrago na segunda seguinte, somando pedidos perdidos e horas extras da equipe. Situações assim se repetem em empresas que tratam a TI como caixa-preta. Os indicadores de TI existem para acabar com essa cegueira.
SLA, MTTR e backlog formam o ponto de partida. Esses três números mostram se o suporte cumpre o que prometeu, em quanto tempo os problemas voltam a funcionar e se a fila de pedidos está sob controle. Bem apresentados, eles traduzem a tecnologia para a língua que a diretoria fala, a do risco e do dinheiro.
Hora parada custa caro, e o preço vem subindo. Na pesquisa anual do Uptime Institute publicada em 2026, 57% das organizações afirmaram que a interrupção mais recente custou mais de 100 mil dólares, e uma em cada cinco passou de 1 milhão. Uma PME brasileira opera em outra escala, só que a proporção do estrago sobre o caixa costuma ser até pior. Quando o faturamento depende de sistema no ar, cada hora fora do ar sai do bolso do dono.
Este guia explica os principais indicadores em linguagem de negócio, sem fórmula complicada. Você vai ver o que medir, quais metas usar como referência e como montar um painel que a diretoria consegue ler em meio minuto.
Para que servem os indicadores de TI na mesa da diretoria?
Indicadores de TI são números que medem a qualidade, a velocidade e o custo do serviço de tecnologia, como o percentual de chamados resolvidos dentro do prazo. Eles servem para o dono enxergar risco e capacidade de entrega sem depender de tradução técnica.
O técnico olha métricas granulares, como uso de processador ou latência da rede. A diretoria precisa de outra altitude. Interessa saber se a operação cumpre o combinado, se os problemas voltam e quanto custa cada falha. Relatório técnico de 30 páginas responde tudo e não comunica nada; vira papel que ninguém lê.
Na prática, o trio básico responde às três perguntas que todo dono já fez:
- O que foi prometido está sendo cumprido? É o SLA.
- Os problemas são resolvidos rápido? É o MTTR.
- A fila de demandas anda? É o backlog.
Empresas com gestão madura organizam essas medições em camadas. Os números operacionais ficam na tela da equipe de suporte, atualizados o dia inteiro. Um resumo tático orienta o gestor da área. No topo, poucos indicadores estratégicos chegam à reunião mensal de diretoria, sempre acompanhados de tendência e de impacto financeiro.
O que é SLA e como cobrar esse acordo do fornecedor?
SLA (Service Level Agreement, ou acordo de nível de serviço) é o compromisso formal que define prazos e condições mínimas do atendimento de TI. No dia a dia, o número aparece como percentual de chamados resolvidos dentro do prazo combinado. Um SLA de 95% em prioridade alta significa 95 chamados críticos resolvidos no prazo a cada 100 abertos.
Um número global engana. A operação pode exibir 97% no consolidado e falhar justamente nos chamados do sistema financeiro, que são os que doem no caixa. Peça o SLA aberto por prioridade, por tipo de serviço e por área da empresa. Médias escondem padrões que só aparecem quando o relatório é fatiado.
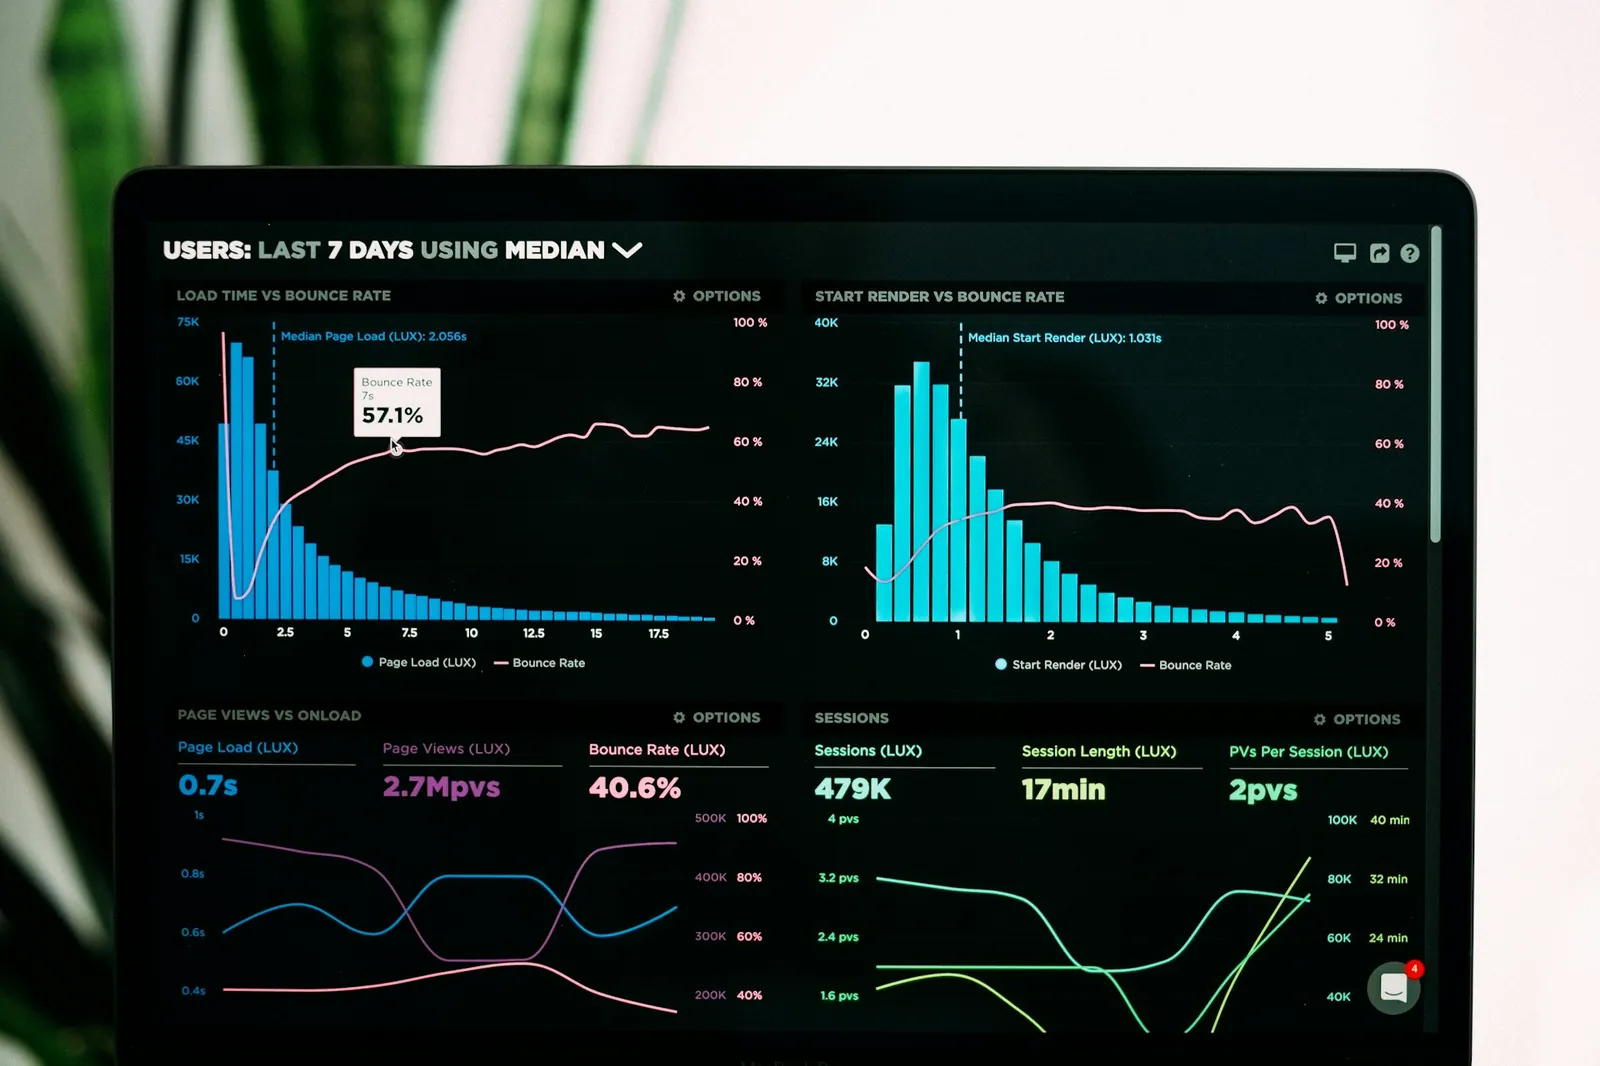
O cálculo considera o tempo entre a abertura e a resolução de cada chamado, comparado ao prazo contratado para aquela prioridade. Sistemas de ITSM (gestão de serviços de TI) fazem essa conta sozinhos e disparam alerta quando um chamado está perto de estourar. O aviso antecipado permite corrigir o curso no mesmo dia, em vez de descobrir a violação no fechamento do mês.
Prazo realista importa mais que prazo bonito. Acordo apertado demais queima a equipe e gera disputa a cada chamado; acordo frouxo deixa a empresa desprotegida. O contrato precisa prever revisão periódica, porque o negócio muda e o acordo tem de acompanhar. Diretoria participa dessa conversa, em vez de assistir de fora.
Para quem terceiriza o suporte, o SLA é a principal régua do contrato. Antes de assinar, vale ler sobre quando vale a pena terceirizar serviços de TI e exigir que o acordo venha com relatório mensal. Fornecedor que esconde o próprio desempenho está dizendo algo sobre o serviço.
O que é MTTR e por que ele mede o custo da hora parada?
MTTR (Mean Time to Repair, ou tempo médio de reparo) mede quanto tempo a equipe leva, em média, para devolver um serviço ao ar depois de uma falha. A conta é direta. Basta somar o tempo de reparo de todos os incidentes do período e dividir pelo número de incidentes.
Número baixo nem sempre é boa notícia. Um MTTR de 20 minutos pode esconder a mesma falha simples voltando toda semana, resolvida no improviso e nunca na causa. Por isso a leitura exige companhia de outros números, como a taxa de reincidência e o MTBF, o tempo médio entre falhas.
Outro cuidado é combinar o que entra na conta. Muitas empresas contam só o tempo de atuação técnica e ignoram a detecção e a espera por aprovação, o que embeleza o resultado. Padronize as etapas medidas, da detecção à recuperação, e as comparações entre meses passam a valer alguma coisa.
A diretoria deve olhar o MTTR dos serviços que sustentam a receita, antes de qualquer média geral. Pouco importa a média baixa se o sistema de faturamento leva seis horas para voltar. Metas mais duras para os sistemas críticos, metas normais para o resto. Essa segmentação muda a conversa sobre risco.
Reduzir o MTTR passa por monitoramento que avisa antes de o usuário reclamar, por procedimento documentado e por automação nas tarefas repetitivas. Ferramentas com inteligência artificial ajudam no diagnóstico e na triagem, com gente experiente decidindo o que fazer.
O que o backlog de TI revela sobre o seu suporte?
Backlog é a fila de tudo o que aguarda atendimento na TI, do chamado simples ao projeto parado. Nos indicadores de TI, ele funciona como termômetro da capacidade de entrega. Fila crescente mês após mês indica demanda maior que a equipe, processo travado ou os dois ao mesmo tempo.
Contar itens pendentes diz pouco. O que revela o problema é a idade e a prioridade de cada item da fila. Uma lista com 200 chamados simples abertos há menos de um dia é rotina; 50 chamados críticos parados há três dias são um incêndio. Peça o backlog fatiado por idade, sempre.
Fila que só cresce costuma ter causa estrutural. Equipe subdimensionada, processo manual, retrabalho por falha recorrente, dependência de um único técnico que virou gargalo. O mapeamento do caminho do chamado, da abertura ao encerramento, mostra onde o fluxo trava.
No curto prazo, mutirão resolve, com priorização pelo impacto e reforço temporário na equipe. A solução duradoura vem de outro lugar, da automação do que é repetitivo e do autoatendimento para pedidos simples, como troca de senha. Menos chamado trivial entrando, mais fôlego para o que importa.
Para a diretoria, o backlog se apresenta em forma de consequência. Quantas horas de produtividade a fila está consumindo, quais projetos atrasaram por falta de braço na TI, qual o custo acumulado disso. Sem essa tradução, a fila parece problema do suporte. Com ela, vira pauta de orçamento.
Quais indicadores completam o painel executivo?
Além do trio principal, quatro medições completam a visão executiva. A disponibilidade, o MTBF, a taxa de reabertura de chamados e a satisfação do usuário cobrem a estabilidade da infraestrutura, a confiabilidade dos equipamentos e a qualidade percebida do serviço.
Disponibilidade é o percentual de tempo em que um serviço fica no ar e acessível. O MTBF (Mean Time Between Failures) mostra quanto tempo um equipamento ou sistema costuma operar entre uma falha e a próxima, e por isso indica confiabilidade. Juntos, os dois justificam investimento em redundância e manutenção preventiva com números, sem achismo.
A taxa de reabertura merece atenção especial. Chamado reaberto é problema que voltou, sinal de diagnóstico raso ou de solução de curativo. Taxas altas revelam retrabalho escondido que nenhum SLA bonito compensa. Já a satisfação do usuário (CSAT), medida em pesquisa curta após o atendimento, captura o que os números frios deixam escapar.
Na segurança, o tempo médio de detecção de ameaças (MTTD) entrou no painel das empresas que levam risco a sério. Em um ataque de ransomware, o golpe que sequestra os dados da empresa e cobra resgate, cada minuto sem detecção amplia o prejuízo. O mesmo raciocínio vale para o tempo de resposta a incidentes.
Esses números conversam entre si, e o cruzamento rende os melhores diagnósticos. Um MTTR alto no sistema de autenticação pode indicar fragilidade que facilita invasão. Uma fila crescente de atualizações de segurança pendentes escancara a porta para ataques conhecidos. O painel ganha valor quando conecta a operação ao risco.
Empresas que desenvolvem software ou rodam tudo em nuvem acrescentam medições próprias, como frequência de entregas, taxa de falha em mudanças e custo por recurso contratado. O princípio permanece. Já publicamos sobre métricas de TI que toda empresa deveria aplicar, e a lógica segue a mesma, com o painel sempre amarrado ao resultado do negócio.
Quais metas de referência usar para cada indicador?
Referências comuns de mercado apontam SLA de 95% ou mais em prioridade alta, MTTR abaixo de 4 horas para sistemas críticos, disponibilidade mínima de 99,9% e taxa de reabertura de até 5%. Os valores servem de ponto de partida, nunca de tabela universal.
A tabela resume como calcular e como interpretar cada um dos indicadores de TI do painel executivo.
| Indicador | Como calcular | Meta de referência | O que diz ao negócio |
|---|---|---|---|
| SLA | (chamados no prazo ÷ total de chamados) × 100 | 95% ou mais na prioridade alta | Cumprimento do combinado |
| MTTR | soma dos tempos de reparo ÷ número de incidentes | abaixo de 4 horas em sistemas críticos | Velocidade de recuperação |
| Backlog | fila pendente, fatiada por idade e prioridade | chamado crítico resolvido em até 24 horas | Capacidade de entrega |
| Disponibilidade | (tempo total menos tempo parado) ÷ tempo total × 100 | 99,9% ou mais em sistemas críticos | Estabilidade da operação |
| MTBF | tempo em operação ÷ número de falhas | quanto maior, melhor | Confiabilidade dos ativos |
| Taxa de reabertura | (chamados reabertos ÷ encerrados) × 100 | até 5% | Qualidade das resoluções |
O contexto manda. Cada empresa ajusta esses números à criticidade dos próprios sistemas e ao que o contrato prevê, de preferência em conversa aberta entre a diretoria e quem opera o atendimento. Meta boa é a que desafia sem virar ficção. Meta sem revisão periódica envelhece rápido, porque a operação muda.
Como levar esses indicadores de TI para um dashboard executivo?
Um dashboard executivo eficaz reúne de 5 a 8 indicadores de TI em uma única tela, com status em cores de semáforo e gráficos de tendência. A diretoria precisa entender o quadro em 30 segundos e aprofundar só quando algo estiver amarelo ou vermelho. Meio minuto, nada além disso.
Menos é mais nesse painel. Dezenas de gráficos disputando atenção produzem o mesmo efeito de nenhum gráfico. Escolha os números ligados a receita, a custo e a risco, e deixe o detalhe operacional nas telas da equipe técnica. Tendência vale mais que foto; o número isolado de um mês não conta a história.
Nem tudo precisa de tempo real. SLA e MTTR se beneficiam de dados frescos, enquanto backlog e satisfação podem ser atualizados por semana ou por quinzena. O ritmo de atualização acompanha o ritmo da decisão que cada número alimenta.
Quanto à origem dos dados, o painel bebe de várias fontes ao mesmo tempo. A ferramenta de chamados fornece SLA e backlog, o monitoramento de infraestrutura entrega disponibilidade e MTTR, e a pesquisa de satisfação fecha o conjunto. Integrar tudo em uma visão única dá trabalho uma vez e economiza explicação para sempre.
O erro mais comum é o painel imposto de cima para baixo, montado pela TI sem perguntar o que a diretoria quer decidir. Comece pelas perguntas, depois escolha os números que as respondem. Painel que ninguém pediu acaba aberto uma vez por trimestre.
Com que frequência a diretoria deve revisar os números?
A cadência de referência é semanal para SLA e MTTR, quinzenal ou mensal para backlog e satisfação, com um espaço fixo na pauta da reunião de governança. Alertas automáticos cobrem o intervalo, avisando quando um indicador crítico estoura o limite.
Na reunião, o gestor técnico apresenta a tendência e explica as variações. O papel da diretoria é fazer a pergunta de negócio. O que esse número significa para o cliente, para a produtividade, para o caixa. Esse vaivém cria responsabilidade dos dois lados e tira a TI do isolamento.
Cultura pesa mais que ferramenta nessa rotina. Quando o dono pergunta pelos números, sugere meta e reconhece a melhoria, a equipe técnica percebe que o trabalho é visto. O efeito aparece na qualidade das entregas. Quando ninguém olha, o painel vira paisagem em um mês.
Aqui vai uma opinião formada em décadas de atendimento. Indicador sozinho conserta pouco; ele mostra onde doer primeiro, e só. Já vi relatório impecável convivendo com cliente insatisfeito, porque a equipe otimizava o número e esquecia a experiência de quem abre o chamado. Medir é o começo. Agir sobre o que a medição mostra é o que separa painel de enfeite.
Perguntas frequentes sobre indicadores de TI
Quantos indicadores a diretoria deve acompanhar?
De 5 a 8 em uma única tela, sem rolagem. O conjunto mínimo cobre SLA, MTTR, backlog e disponibilidade, com taxa de reabertura e satisfação do usuário como complemento. Painéis maiores dispersam a atenção e acabam ignorados. O detalhe operacional fica nas telas da equipe técnica, à disposição de quem precisar aprofundar.
O que é um bom SLA para uma PME?
Uma referência comum de mercado é 95% ou mais dos chamados de prioridade alta resolvidos dentro do prazo, com prazos por criticidade definidos em contrato. Mais importante que o percentual é a transparência. Exija relatório mensal com o indicador aberto por prioridade e por área, para a média deixar de esconder falhas nos sistemas que mais importam.
Qual é a diferença entre MTTR e MTBF?
MTTR mede o tempo médio para reparar uma falha e devolver o serviço ao ar; quanto menor, melhor. MTBF mede o tempo médio entre uma falha e a seguinte; quanto maior, melhor. O primeiro avalia a agilidade do suporte, o segundo avalia a confiabilidade dos equipamentos e sistemas.
Empresa sem equipe própria de TI consegue acompanhar esses números?
Consegue, e deve. Quem contrata serviços gerenciados de TI recebe esses indicadores do próprio fornecedor, que monitora o ambiente e emite relatório periódico. O papel do dono é definir as metas em contrato e cobrar a apresentação dos resultados. Fornecedor sério entrega o painel sem precisar ser cobrado.
Como a HelpDigital ajuda sua empresa a medir e melhorar a TI
Indicadores de TI transformam a tecnologia em assunto de reunião de diretoria, com SLA, MTTR e backlog respondendo pelo combinado, pela velocidade e pela fila. Quem mede decide com base em fato. O resto é aposta. Quem está sem medição descobre os problemas pelo pior canal possível, o cliente.
Montar e manter esse painel exige ferramenta, processo e rotina, e esse é exatamente o trabalho de um parceiro de serviços gerenciados. Um MSP (Managed Service Provider, o fornecedor que opera a TI da empresa de forma contínua) monitora o ambiente, atende com SLA definido em contrato e apresenta os números a cada mês, sem que o dono precise caçar informação.
A HelpDigital é uma rede de franquias de TI com foco em serviços gerenciados, com sede em Goiânia (GO). As unidades franqueadas atendem empresas da própria região com a metodologia e o suporte da rede, o que inclui monitoramento contínuo e a disciplina de indicadores que este artigo descreveu.
Se a TI da sua empresa ainda é uma caixa-preta, conheça os serviços da HelpDigital em helpdigitalti.com.br e converse com a unidade da sua região. E se você é profissional de TI pensando em empreender com método, veja o modelo de franquia HelpDigital.
Publicado em 19 de outubro de 2026.
Fernando Aurelio é Founder & CEO da HelpDigital, com mais de 30 anos de experiência em TI e mais de 20 anos à frente de negócios. Lidera a rede de franquias de serviços gerenciados a partir de Goiânia (GO).